

根据周四解封的法庭文件以及《纽约时报》的报道,微软员工曾内部讨论OpenAI使用新闻文章训练模型是否等同于“人类历史上最大的劳动窃取”,并可能引发布模型退化的“厄运循环”。
这些文件源自《纽约时报》于2023年底对微软和OpenAI提起的诉讼,此后另有十一家出版商加入。OpenAI一直否认相关指控,案件已迫使该公司保留2000万条ChatGPT对话日志。纽约南区法官西德尼·斯坦(Sidney Stein)正在审议即决判决动议,相关文件随之解封。
一份微软2023年的内部文件称:“全球数百万用户很快将认为大模型‘吞噬’其所有作品是空前比例的惊人盗窃。”同一作者写道,大型AI模型“是一种摧毁自身供应链的产品”。微软表示,这些备忘录由应用科学总监布伦特·赫克特(Brent Hecht)撰写,不代表公司立场,他仅负责“提供分歧与非对称视角”。
微软CEO萨提亚·纳德拉(Satya Nadella)作证称,“任何付费墙内容都应被希望使用的人授权”,若早知OpenAI用付费墙内容训练,他会行使微软权利令其重新训练。OpenAI方面,有员工向总裁格雷格·布罗克曼(Greg Brockman)提及构建“黑客”手段绕过NYT付费墙,布罗克曼回复:“啊,不错。”
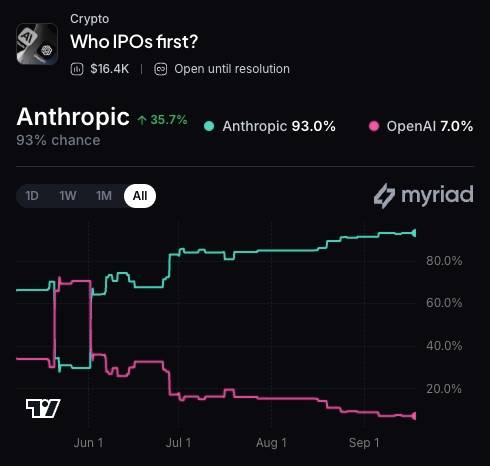
Myriad: OpenAI or Anthropic IPOs first? Click to make your prediction.
ChatGPT团队负责人尼克·特利(Nick Turley)在2023年6月写道AI对出版商构成“生存威胁”,并在次年2月称AI产品“随着改进将越来越具替代性”。一名OpenAI工程师2023年2月表示用户不会点击链接,这削弱了聊天机器人向出版商引流的论点。
前政策总监杰克·克拉克(Jack Clark)在2020年备忘录中警告公司“正在创造替代社会‘文化’定义者劳动的系统”,并会“成为硅谷草率踏入生活其他领域并留下一地鸡毛的象征”。克拉克后离职共同创立Anthropic。
微软与OpenAI均主张训练属“公平使用”,将文章转化为新作品而非替代。原告律师称世界可见其真实想法。《纽约时报》拒绝对自家记者置评。